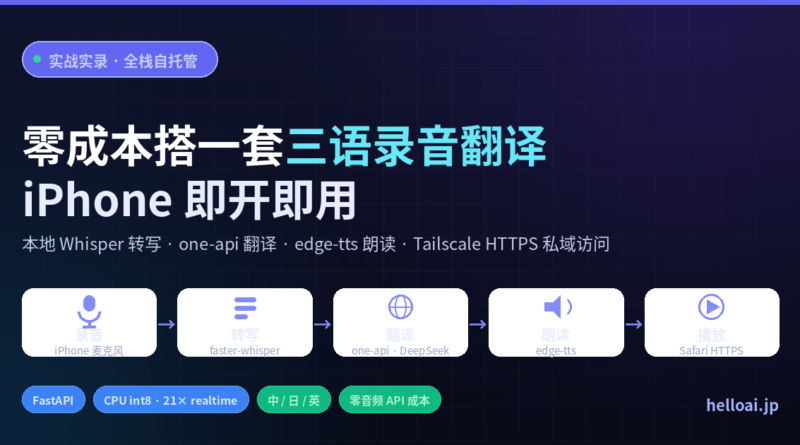
从零到可用的完整实践:本地 Whisper 转写 + one-api 翻译 + edge-tts 语音合成,通过 Tailscale HTTPS 在 iPhone 上直接使用。
一、目标
在已有的 VPS(Ubuntu 22.04,5.8G 内存,无 GPU)上,做一个中日英三语的录音翻译应用:
- iPhone 麦克风直接录音输入
- 语音自动转文字(语种自动识别)
- 翻译成目标语言(中/日/英任选)
- 译文语音朗读(TTS)
- 仅自己/团队可访问,不对外暴露
二、最终形态
iPhone Safari (HTTPS via tailscale serve:8443)
→ MediaRecorder 录音
→ FastAPI :8091
→ faster-whisper (base/int8, CPU) 转写 + 语种识别
→ one-api :3000 (deepseek-v4.1-flash) 翻译
→ edge-tts 生成译文语音
→ 页面显示原文/译文/耗时,并朗读
三、选型理由
1. STT 用本地 faster-whisper,不走外部 API
VPS 已装 faster-whisper 1.2.1 + torchaudio + ffmpeg。本地跑:零音频 API 成本、数据不出机器、base + int8 在 CPU 上约 21x realtime(60 秒音频 2.8 秒转完)。
2. 翻译走已有 one-api
VPS 已有 one-api(OpenAI 兼容网关),实测 deepseek-ai/deepseek-v4.1-flash 稳定可用,中文→日语质量好、延迟低。不需要新建翻译服务。
3. HTTPS 用 tailscale serve,不碰 nginx 443
443 已被其他服务占用,且 iOS Safari 麦克风 API 强制要求 HTTPS,纯 HTTP 下 navigator.mediaDevices 是 undefined。tailscale serve --https=8443 自动签发真实证书,仅 tailnet 内可见。
4. TTS 用 edge-tts
免费、无需 key、中日英神经语音质量好,Python 环境直接可用。
四、分阶段实施与踩坑
阶段 1:环境探测
用只读脚本确认 STT 能力与 one-api 模型。关键发现:faster-whisper 已装可本地转写;workspace 里的 .wav 大多是废文件(实为 HTML 或损坏)。
阶段 2:STT 验证
踩坑 1:用错误样本测试,误判引擎有问题
lianqu1990.wav 实际是 HTML 文件(file 显示 HTML document)。改用真正的 lianqu1990.mp3(5分22秒)转 16k 单声道 WAV 后:
detected=zh prob=0.99 elapsed=2.8s
TEXT: 和你弟弟笑怎么也能往眼里转又时光就这么留...结论:引擎没问题,是样本坏了。验证前先 file + ffprobe 确认素材有效。
阶段 3:翻译验证
one-api 真实数据库(容器挂载的 /home/user/one-api/one-api.db)与 workspace 旧快照完全不同。真实可用:
| 模型 | 状态 |
|---|---|
deepseek-ai/deepseek-v4.1-flash |
✅ 稳定,首选 |
nvidia/nemotron-3-super-120b-a12b |
❌ 上游 404 |
gpt-oss:120b |
⚠️ 429 负载饱和 |
中文→日语实测:
今天天气很好,我们去吃饭吧
→ 今日はいい天気ですね、ご飯を食べに行きましょう
踩坑 2:直接读 workspace 的 db 快照会得到过时模型清单,必须读容器真实挂载的库。
阶段 4:FastAPI 服务化
踩坑 3:one-api 偶发超时
首次音频请求报 ReadTimeout (60s)。修复:超时 90s + 重试 1 次。根因是上游渠道轮询可能落到慢渠道。
阶段 5:HTTPS 接入
踩坑 4:iOS 纯 HTTP 下麦克风不可用
http://<tailscale-ip>:8091 访问时 navigator.mediaDevices 是 undefined,点录音报 undefined is not an object。解决:tailscale serve --bg --https=8443 8091。
踩坑 5:tailscale serve --bg 报 443 已被占用
foreground listener already exists for port 443。不要 reset(会清掉所有 serve 规则,包括别的服务),改用独立端口 8443。
踩坑 6(最深):HTML 内嵌 Python 字符串被转义截断
现象:iPhone 点录音毫无反应,加 window.onerror 后显示 Unexpected EOF @line 73。
根因:HTML = """...""" 里的 JS 字符串 '\n\n' 经 shell heredoc → Python → HTML 多层转义,变成真实换行,导致 JS 字符串跨行、语法错误、整个 <script> 不执行。
解决:
- HTML 独立成
ui.html文件,用cat <<'HTMLEOF'(单引号 heredoc,零转义)写入 - FastAPI 用
FileResponse返回该文件 - JS 里避免模板字符串,用
var+function+then,换行全用'\n\n'字面量拼接
踩坑 7:FileResponse 未导入
删除内嵌 HTML 后 ui() 改用 FileResponse,但导入没加,/ 返回 500(NameError: FileResponse is not defined)。补导入即可。
五、最终代码
文件结构
/root/.openclaw/workspace/translate-app/
├── app.py      # FastAPI 后端
├── ui.html     # iPhone 录音页(88 行,独立文件)
└── .env # 配置(权限 600).env(token 自行填写,勿提交到仓库)
ONEAPI_BASE=http://127.0.0.1:3000/v1
ONEAPI_KEY=sk-xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx
MT_MODEL=deepseek-ai/deepseek-v4.1-flash
app.py
import os, time, tempfile
from fastapi import FastAPI, UploadFile, File, Form, HTTPException
from fastapi.middleware.cors import CORSMiddleware
from fastapi.responses import Response, HTMLResponse, FileResponse
from pydantic import BaseModel
import requests
import edge_tts
from faster_whisper import WhisperModel

ONEAPI_BASE = os.getenv("ONEAPI_BASE", "http://127.0.0.1:3000/v1")
ONEAPI_KEY  = os.getenv("ONEAPI_KEY", "")
MODEL       = os.getenv("MT_MODEL", "deepseek-ai/deepseek-v4.1-flash")

app = FastAPI(title="audio-translator")
app.add_middleware(CORSMiddleware, allow_origins=["*"],
                   allow_methods=["*"], allow_headers=["*"])

_whisper = None
def whisper():
    global _whisper
    if _whisper is None:
        _whisper = WhisperModel("base", device="cpu", compute_type="int8")
    return _whisper

LANG_NAME = {"zh": "中文", "ja": "日语", "en": "英语"}
VOICE_MAP = {
    "zh": "zh-CN-XiaoxiaoNeural",
    "ja": "ja-JP-NanamiNeural",
    "en": "en-US-JennyNeural",
}

def mt(text: str, target: str) -> str:
    prompt = ("把下面文本翻译成" + LANG_NAME.get(target, target)
              + ",只输出译文,不要解释:\n" + text)
    last = None
    for _ in range(2):  # 重试 1 次
        try:
            r = requests.post(
                ONEAPI_BASE + "/chat/completions",
                headers={"Authorization": "Bearer " + ONEAPI_KEY},
                json={"model": MODEL,
                      "messages": [{"role": "user", "content": prompt}],
                      "temperature": 0.2},
                timeout=90,
            )
            r.raise_for_status()
            return r.json()["choices"][0]["message"]["content"].strip()
        except requests.exceptions.RequestException as e:
            last = e
            time.sleep(2)
    raise HTTPException(502, "翻译失败:" + str(last))

class TextReq(BaseModel):
    text: str
    target: str = "ja"

@app.get("/health")
def health():
    return {"ok": True, "model": MODEL}

@app.post("/api/translate/text")
def translate_text(req: TextReq):
    return {"translation": mt(req.text, req.target)}

@app.post("/api/translate")
async def translate_audio(file: UploadFile = File(...),
                          target: str = Form("ja")):
    suffix = os.path.splitext(file.filename or "a")[1] or ".wav"
    with tempfile.NamedTemporaryFile(delete=False, suffix=suffix) as f:
        f.write(await file.read())
        path = f.name
    try:
        t0 = time.time()
        segs, info = whisper().transcribe(
            path, language=None, beam_size=5, vad_filter=True)
        src_text = "".join(s.text for s in segs).strip()
        stt_sec = time.time() - t0
        if not src_text:
            raise HTTPException(400, "未识别到语音")
        t1 = time.time()
        out = mt(src_text, target)
        return {
            "src_lang": info.language,
            "src_prob": round(info.language_probability, 3),
            "src_text": src_text,
            "target": target,
            "translation": out,
            "stt_sec": round(stt_sec, 2),
            "mt_sec": round(time.time() - t1, 2),
        }
    finally:
        os.unlink(path)

@app.post("/api/tts")
async def tts(req: TextReq):
    voice = VOICE_MAP.get(req.target, "en-US-JennyNeural")
    buf = bytearray()
    async for chunk in edge_tts.Communicate(req.text, voice).stream():
        if chunk["type"] == "audio":
            buf.extend(chunk["data"])
    if not buf:
        raise HTTPException(502, "TTS 生成失败")
    return Response(content=bytes(buf), media_type="audio/mpeg",
                    headers={"Cache-Control": "no-store"})

@app.get("/")
def ui():
    return FileResponse(
        "/root/.openclaw/workspace/translate-app/ui.html",
        media_type="text/html",
    )
ui.html
<!doctype html><html lang="zh"><head>
<meta charset="utf-8"><meta name="viewport" content="width=device-width,initial-scale=1">
<title>中日英录音翻译</title>
<style>
body{font-family:-apple-system,sans-serif;margin:0;padding:16px;background:#f5f5f7}
h2{margin:8px 0}
button{font-size:18px;padding:14px 20px;border-radius:12px;border:0;margin:6px 0;width:100%}
#rec{background:#e63946;color:#fff}
#stop{background:#333;color:#fff;display:none}
select{font-size:16px;padding:8px;border-radius:8px;margin:6px 0;width:100%}
#out{background:#fff;border-radius:12px;padding:14px;margin-top:14px;white-space:pre-wrap;font-size:15px;min-height:80px}
</style></head><body>
<h2>🎤 录音翻译(中↔日↔英)</h2>
<select id="target">
  <option value="ja">翻译成 日语</option>
  <option value="zh">翻译成 中文</option>
  <option value="en">翻译成 英语</option>
</select>
<button id="rec">● 开始录音</button>
<button id="stop">■ 停止并翻译</button>
<div id="out"></div>
<script>
window.onerror = function(msg, src, line, col){
  var o = document.getElementById('out');
  if (o) o.textContent = 'JS错误: ' + msg + ' @line ' + line + ':' + col;
  return false;
};
var mr = null, chunks = [], audioCtx = null;
var out = document.getElementById('out');
var rec = document.getElementById('rec');
var stop = document.getElementById('stop');
function unlockAudio() {
  if (audioCtx) return;
  try {
    audioCtx = new (window.AudioContext || window.webkitAudioContext)();
    audioCtx.resume();
    var b = audioCtx.createBuffer(1, 1, 22050);
    var s = audioCtx.createBufferSource();
    s.buffer = b; s.connect(audioCtx.destination); s.start(0);
  } catch (e) { out.textContent = '音频解锁失败: ' + e; }
}
function playMp3(ab) {
  if (!audioCtx) { out.textContent += ' (音频未解锁)'; return; }
  audioCtx.decodeAudioData(ab).then(function(d) {
    var s = audioCtx.createBufferSource();
    s.buffer = d; s.connect(audioCtx.destination); s.start(0);
    out.textContent += ' 已播放';
  }).catch(function(e) { out.textContent += ' 播放失败: ' + e; });
}
rec.onclick = function() {
  unlockAudio();
  out.textContent = '请求麦克风…';
  navigator.mediaDevices.getUserMedia({audio: true}).then(function(stream) {
    mr = new MediaRecorder(stream); chunks = [];
    mr.ondataavailable = function(e) { chunks.push(e.data); };
    mr.onstop = function() {
      var blob = new Blob(chunks, {type: 'audio/webm'});
      out.textContent = '上传识别中…';
      var fd = new FormData();
      fd.append('file', blob, 'rec.webm');
      var target = document.getElementById('target').value;
      fd.append('target', target);
      fetch('/api/translate', {method: 'POST', body: fd}).then(function(r) {
        return r.json().then(function(j) { return {ok: r.ok, j: j}; });
      }).then(function(res) {
        if (!res.ok) { out.textContent = '错误: ' + JSON.stringify(res.j); return; }
        var j = res.j;
        out.textContent = '识别(' + j.src_lang + '): ' + j.src_text + '\n\n译文: ' + j.translation + '\n\nSTT ' + j.stt_sec + 's · 翻译 ' + j.mt_sec + 's\n\n🔊 生成语音…';
        return fetch('/api/tts', {
          method: 'POST',
          headers: {'Content-Type': 'application/json'},
          body: JSON.stringify({text: j.translation, target: target})
        }).then(function(tr) {
          if (tr.ok) { return tr.arrayBuffer().then(playMp3); }
          out.textContent += ' TTS失败';
        });
      }).catch(function(e) { out.textContent = '请求失败: ' + e; });
    };
    mr.start();
    rec.style.display = 'none'; stop.style.display = 'block';
    out.textContent = '🔴 录音中… 说完点停止';
  }).catch(function(e) { out.textContent = '无法访问麦克风: ' + e; });
};
stop.onclick = function() {
  if (mr && mr.state !== 'inactive') mr.stop();
  rec.style.display = 'block'; stop.style.display = 'none';
};
</script></body></html>
启动命令
cd /root/.openclaw/workspace/translate-app
set -a; source .env; set +a
nohup uvicorn app:app --host 127.0.0.1 --port 8091 > /tmp/translate.log 2>&1 &
Tailscale HTTPS 入口
tailscale serve --bg --https=8443 8091
tailscale serve status
# → https://<机器名>.ts.net:8443/ → http://127.0.0.1:8091
六、关键运维命令
# 健康检查
curl -s http://127.0.0.1:8091/health

# 文本翻译测试
curl -s -X POST http://127.0.0.1:8091/api/translate/text \
  -H "Content-Type: application/json" \
  -d '{"text":"今天天气很好","target":"ja"}'

# 音频翻译测试
curl -s -X POST http://127.0.0.1:8091/api/translate \
  -F "file=@/tmp/test.wav" -F "target=ja"

# 确认页面完整(应 88 行)
curl -s http://127.0.0.1:8091/ | wc -l
七、可复用清单
- 验证音频素材:
file x.wav && ffprobe x.wav,防废文件 - STT 转 16k 单声道:
ffmpeg -i in.mp3 -ar 16000 -ac 1 out.wav - 语种策略:
language=None自动检测 +vad_filter=True - 模型选型:读 one-api 真实 db 的 abilities 表,别信旧快照
- HTTPS 接入:iOS 麦克风必须 HTTPS,
tailscale serve --https=端口最省事 - HTML 交付:独立文件 + 单引号 heredoc,绝不内嵌进 Python 字符串
- 前端兼容 iOS:
var+function+then,避免模板字符串和裸换行 - 音频播放:Web Audio API 在用户手势里解锁,避免
<audio>自动播放限制 - 超时容错:one-api 调用 90s + 重试 1 次
- 页面自检:
curl -s :8091/ | wc -l行数异常即知 HTML 被截断
八、后续可增强
- systemd 自启:当前
nohup,重启 VPS 会丢 - key 轮换:测试 key 已多次出现在日志,应吊销重发
- 长音频/实时流:当前”录一段→停止→翻译”,实时字幕需 WebSocket + 流式 Whisper
- 术语库/翻译记忆:复用 mysql-project 缓存高频翻译